Local Voice AI:把语音识别、私有大模型和 TTS 放进自己的电脑
如果想让电脑像语音助手一样听你说话、理解问题,再用自然语音回答,背后要串起来的东西并不少。麦克风采集、语音识别、本地大模型、语音合成、实时音频传输,每一环都可能单独折腾半天。
云端服务当然省事。问题也很明显:语音要上传,网络要稳定,调用还可能产生费用。对会议记录、家庭环境、工作资料这类内容来说,把声音一直交给第三方服务,并不是每个人都能接受。
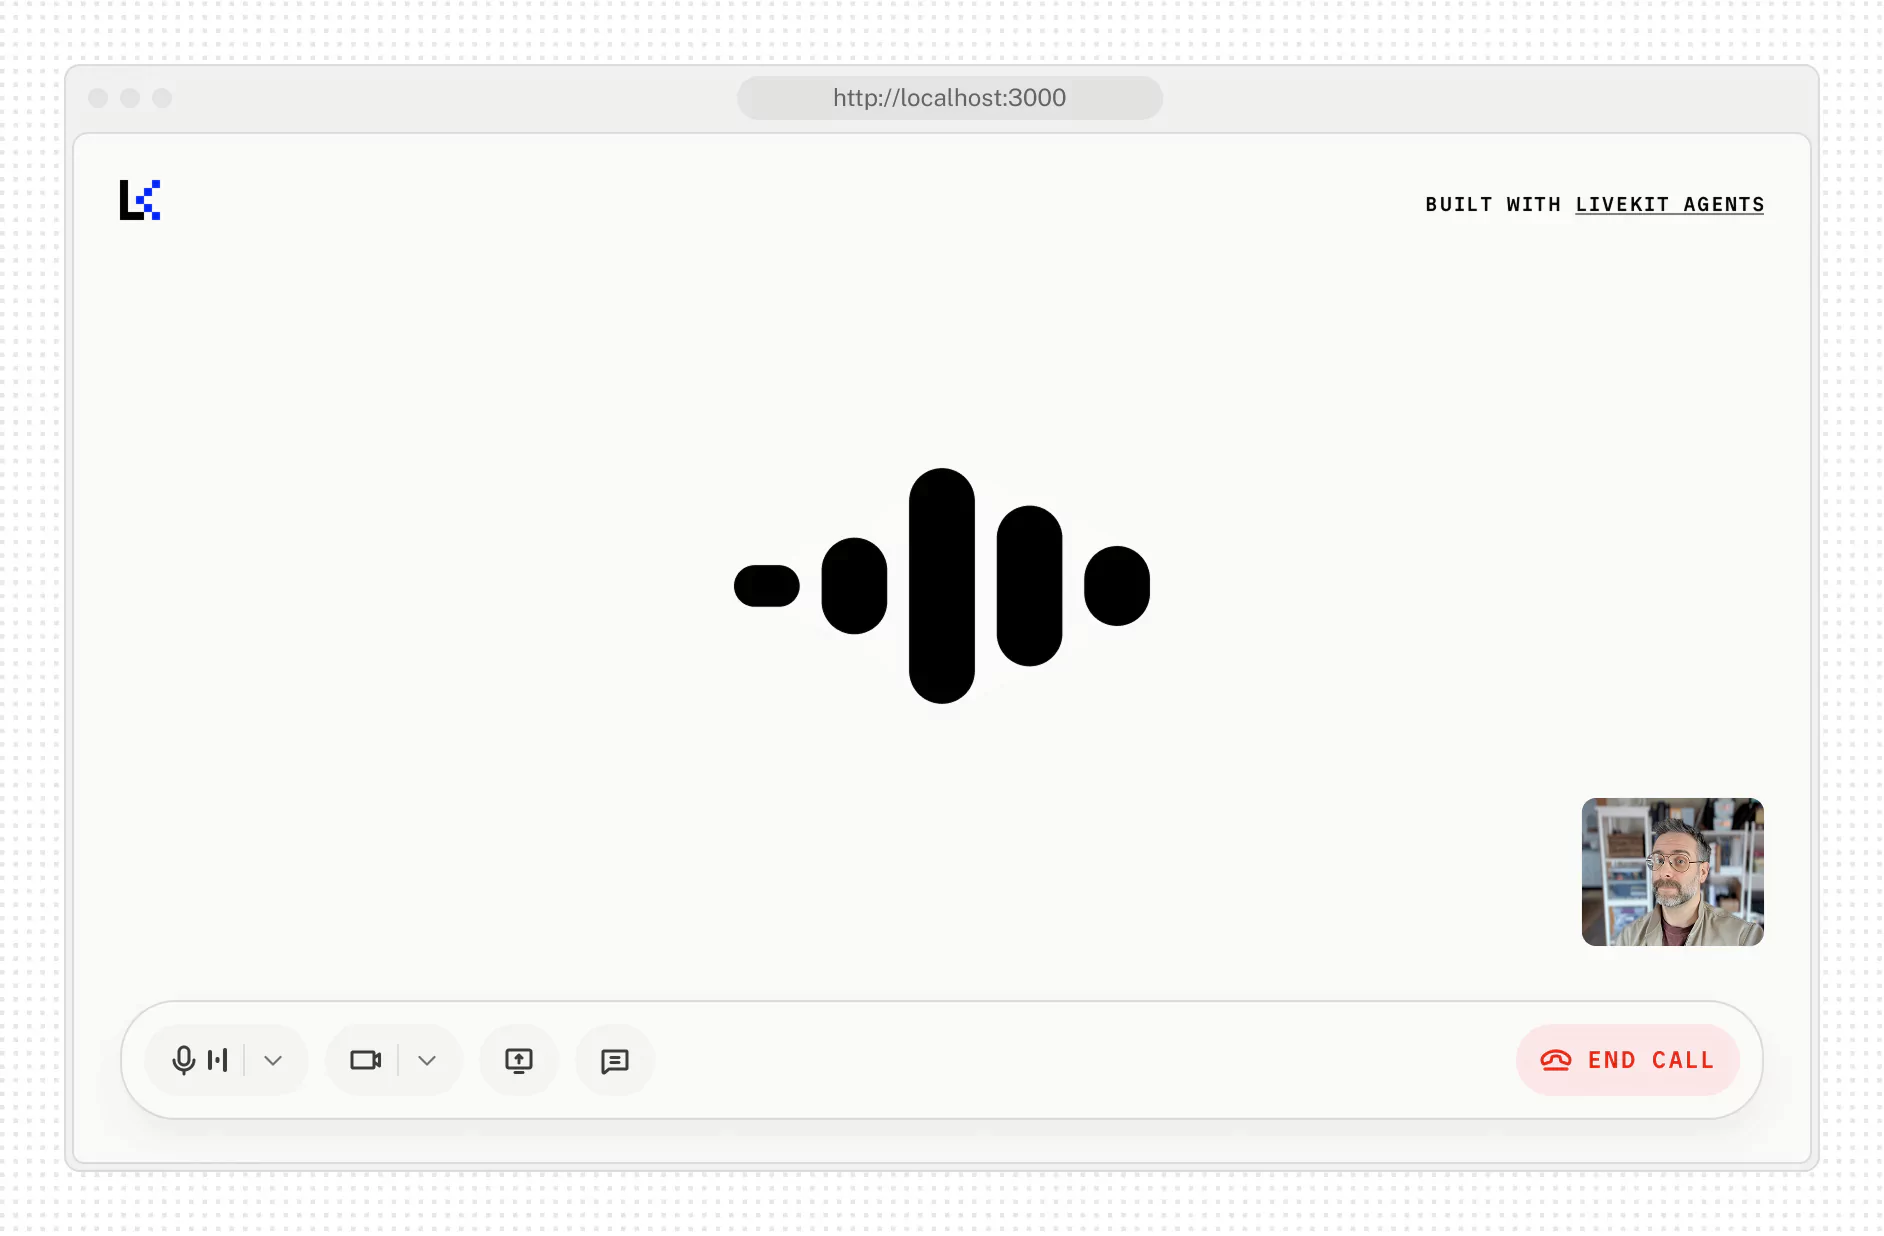
这也是我觉得 Local Voice Agent 值得看的地方。它不是一个安装完就能包治百病的桌面助手,而是把本地语音助手常见的几个组件收进同一套启动流程:先检测硬件,再选择合适的模型和运行配置,最后通过浏览器界面进行语音交互。
这是哪个项目?
这次看的项目是 GitHub 上的 ShayneP/local-voice-ai。仓库名称是 local-voice-ai,README 里的产品名叫 Local Voice Agent,MIT 许可证,关注度在 700 Stars 左右。
需要先说明一件事:我最初看到的线索只写了”Local Voice AI”,提到 Whisper、FAISS、Sentence Transformers、Next.js、Tailwind 和 RAG 知识库检索,但没有给出 GitHub 链接。实际核验时,最匹配的公开仓库是 ShayneP/local-voice-ai。这个仓库目前公开说明里的技术栈并不是那套 RAG 组合,而是 LiveKit Agents、Nemotron Q8 语音识别、llama.cpp 本地语言模型和 Kokoro TTS。
这篇文章只按这个仓库的公开内容来写。没有在 README 中确认的 RAG、FAISS、Sentence Transformers、Next.js 和 Tailwind,我不会把它们当成这个项目的已实现功能。
Local Voice Agent 的定位很清楚:在自己的机器或局域网设备上跑一个低延迟语音助手。LiveKit Agents 负责实时语音代理的编排,Nemotron Q8 处理语音识别,llama.cpp 负责本地大模型推理,Kokoro 把文本回复合成为语音。
它没有只押注高端显卡。README 里给了 CPU、NVIDIA GPU、Apple Silicon 和 Jetson 不同路径,这点对本地 AI 工具来说很重要。很多项目理论上”本地可跑”,实际默认就是为显存充足的机器准备的;这个项目至少把低配、边缘设备和局域网运行的情况单独考虑了。
它解决的不是一个模型问题,而是一条链路问题
很多人搭本地语音助手时会卡在一个误区:以为只要找一个 STT 模型、一个 LLM 模型、一个 TTS 模型,再写点胶水代码就行。真正跑起来才会发现,语音交互和普通聊天不一样。延迟会被放大,模型加载会卡住,浏览器权限、音频输入输出、服务端口、上下文长度都会影响体验。
Local Voice Agent 做的第一件事,是把硬件和模型档位联系起来。项目里有 lean、jetson-realtime、compact、balanced 几种 profile。lean 和 jetson-realtime 更偏轻量,适合内存有限或希望响应更快的设备;compact 和 balanced 会给模型与上下文留更多空间,资源占用也更高。
这类 profile 的意义不是替你”自动变快”,而是减少盲试。不必一上来就下载设备吃不动的模型,也不用在启动失败之后才去翻 issue。先按硬件选择档位,再根据实际体验调整模型,是更现实的路径。
语音闭环也被收在同一个流程里。浏览器采集音频,语音识别把输入转成文本,本地 LLM 生成回复,Kokoro 再合成语音回传给前端。听上去几句话,但每个环节单独配置都不算轻松。项目把这些服务放到一套运行方式里,至少让开发者能从”先跑起来”开始,而不是一开始就卡在组件拼装上。
比较有意思的是 Jetson 路线。README 中提到可以把 Jetson 作为语音服务器,让另一台电脑作为客户端访问。这个思路适合家里或办公室有边缘设备的人:推理服务留在局域网内,交互设备可以更轻。它不是每个人都需要的方案,但对想研究本地语音代理、智能家居入口或边缘 AI 的人来说,有参考价值。
配置方面,项目提供了 .env.local 一类入口。常见可调项包括 LIVEKIT_URL、LLAMA_MODEL、STT_PROVIDER、TTS_VOICE、WAKE_WORD、WEB_PORT。它们分别对应实时通信地址、语言模型路径、语音识别提供方、TTS 声音、唤醒词和 Web 端口。这比把参数散落在多个脚本里更容易维护。
部署体验应该怎么观察
按仓库说明,基本流程是准备 Python 3.10 以上环境,克隆仓库后运行 python3 run.py。脚本会检测当前硬件,给出相应的模型建议和启动路径。服务起来后,浏览器打开 http://localhost:8080,允许麦克风权限,就可以进入语音交互界面。
我不建议把它写成”真正一键部署”。本地 AI 项目第一次运行时,模型下载、Docker 镜像、Python 环境、音频权限都可能出问题。尤其国内网络环境下,模型和依赖下载速度并不总是稳定。更准确的说法是:它把部署入口收拢到一个脚本里,排障时有更清楚的命令可以用。
README 中还提供了非交互配置,以及 status、logs、down 等命令。status 查看服务状态,logs 定位启动失败或模型加载问题,down 停止服务。对经常折腾本地模型的人来说,这些命令比花哨界面更实用。
真要做体验,我会重点看几个地方。
一是首次启动时间。模型下载和服务初始化决定初体验,不同网络和硬盘速度差距会很大。
二是 CPU 下的响应延迟。支持 CPU 运行不等于体验一定流畅,语音助手对延迟很敏感,几秒钟的等待在文字聊天里还能接受,放到语音对话里就会明显打断节奏。
三是更换 profile 后的内存占用。lean、compact、balanced 这些档位背后是模型大小、上下文长度和资源需求的取舍。低配机器可以先从轻量档开始,再逐步试更大的配置。
四是浏览器麦克风权限和音频链路。语音项目的失败原因有时不在模型,而在系统权限、浏览器设置或输入设备选择上。这事很琐碎,但实测时绕不开。
本地运行不等于默认安全
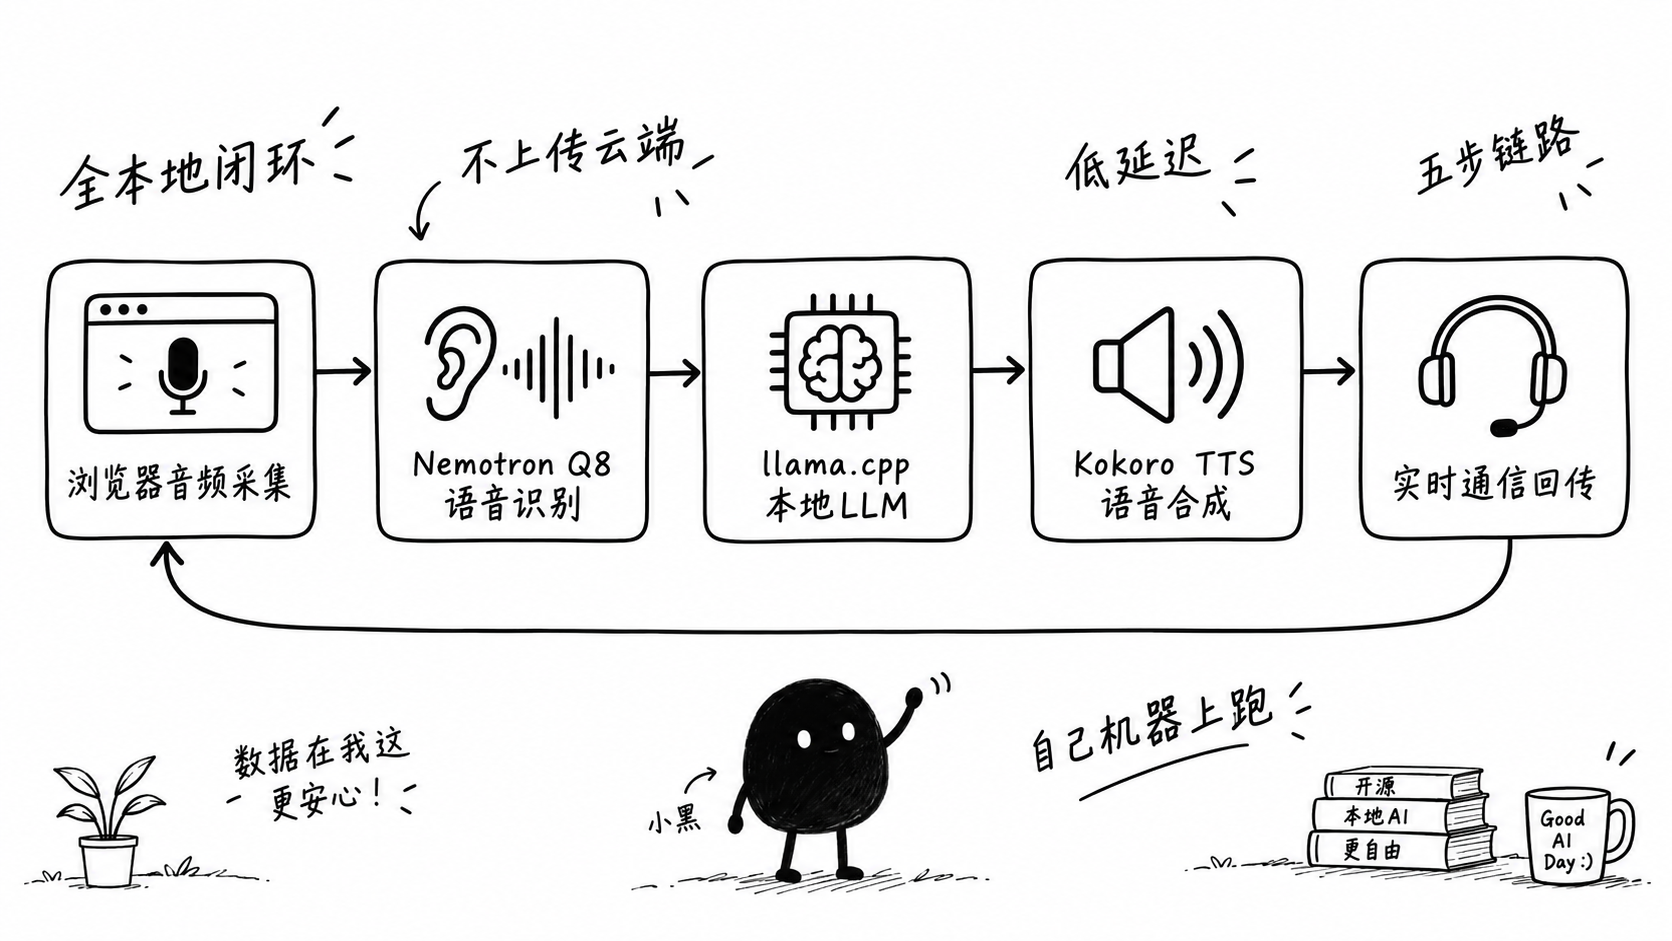
Local Voice Agent 的价值之一,是让语音数据和模型推理尽量留在本机或可信局域网内。对隐私敏感用户来说,这是它比云端语音助手更有吸引力的地方。
但”本地”不应该被理解成”自动安全”。项目会用到 Web 界面、实时通信服务和模型服务,常见端口包括 8080、7880、7881、7882。把这些端口直接暴露到公网,风险就变成了你自己维护的服务风险。模型接口如果没有认证,别人可能访问你的语音服务,甚至占用本地算力。
更稳妥的做法是只在本机或可信局域网内使用。确实需要远程访问时,再考虑 TLS、身份认证、反向代理和防火墙规则。不要为了手机上访问方便,随手把端口映射到公网。
硬件选择也要现实一点。CPU 路线适合学习和原型验证,别期待它在所有设备上都有实时对话体验。NVIDIA GPU 更适合追求更低延迟和更稳定推理的人。Apple Silicon 用户可以走对应的本地优化路径。Jetson 更适合放在局域网里做边缘设备,尤其是你本来就有这类硬件时。
适合谁,不适合谁
Local Voice Agent 更适合愿意动手的人。你能接受命令行、模型下载、端口配置和日志排查,也最好对 STT、LLM、TTS 这些概念有基本了解。如果你的目标是研究一个本地语音助手如何从音频输入走到语音输出,它是一个结构比较完整的参考项目。
它不太适合只想”下载一个软件就开始聊天”的普通用户。这里没有那种双击安装、登录账号、马上可用的消费级体验。它更像一个可运行的开发者项目:关键链路搭好了,但你仍然要根据自己的机器做调整。
我喜欢它的一点,是没有把”本地语音助手”包装得太神秘。听、想、说,每一步都摊开来跑。你可以从中学到实时语音代理的基本链路,也能看到本地模型在真实交互场景里的限制。
如果你关心隐私、想把语音交互留在自己的设备里,或者手里正好有一台 Jetson、Mac mini、Linux 小主机可以折腾,Local Voice Agent 值得放进候选清单。只是别忘了前面的核验说明:本文基于 ShayneP/local-voice-ai 这个仓库,原始线索里提到的 RAG 版本目前还没有找到对应来源。后续如果能确认另一个仓库,再单独补充会更稳妥。
关注「善忘技术夹」全媒体矩阵
扫描上方宣传海报二维码,第一时间获取最新技术文章、开源项目与免安装小程序体验。